Das Projekt
- Kategorie: KI-Infrastruktur
- Rolle: Konzeption und Inbetriebnahme
- Zeitraum: November 2026
- Stack: vLLM, Modal, Python, fp8, spekulatives Decoding
Open-Weight-Modelle im Produktivbetrieb mit OpenAI-kompatiblen APIs
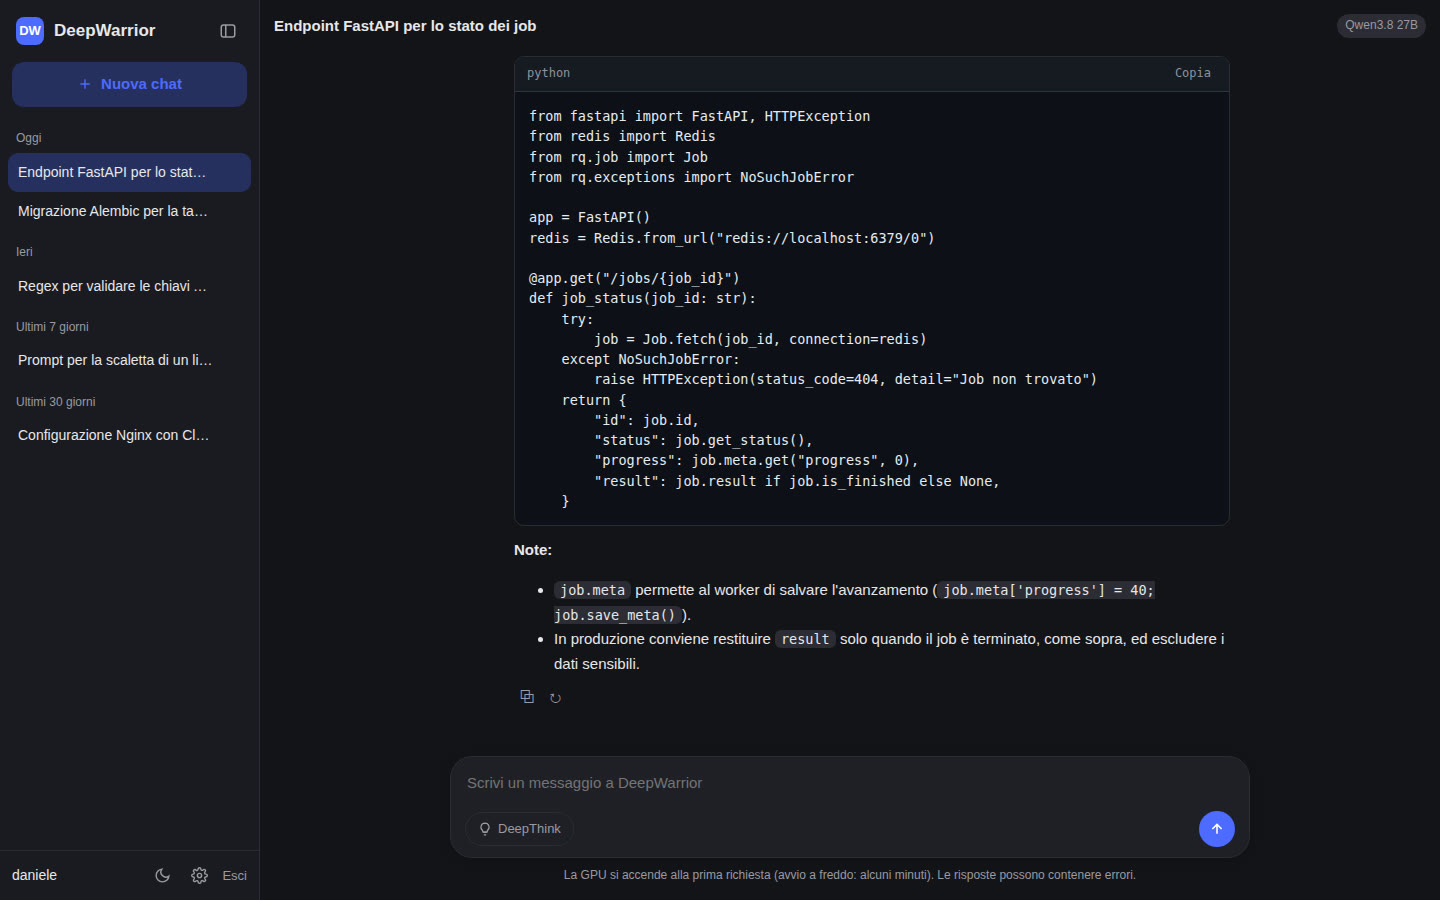
Ich habe auf Cloud-GPUs (Modal) zwei Open-Weight-Sprachmodelle in Betrieb genommen, DeepSeek V4.1 Flash und Qwen3.8 27B, bereitgestellt über OpenAI-kompatible APIs und eine Chat-Weboberfläche. Ziel war es, eigene, günstige und schnelle Modelle für den Einsatz mit Entwicklungsagenten zu haben.
Meine Aufgaben
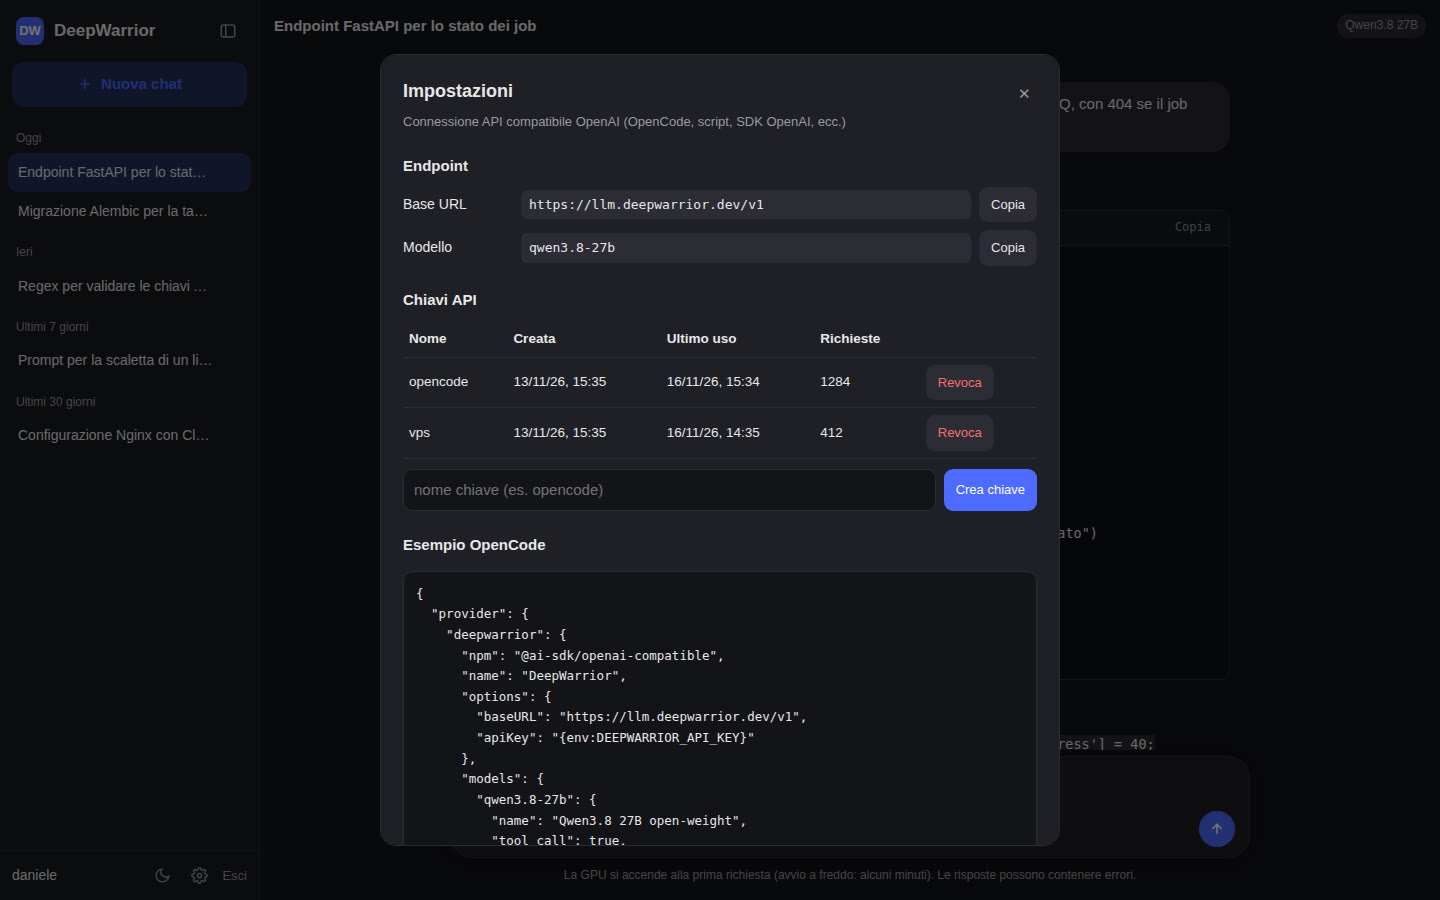
- Serving mit vLLM, widerrufbare API-Schlüssel, Rate Limits und Chat-Weboberfläche
- GPU, die sich bei Nichtgebrauch automatisch abschaltet, um die Kosten niedrig zu halten
- fp8-Quantisierung und spekulatives Decoding (DFlash2): rund 300 Token/s gemessen auf H200
- Modelle angebunden an die Coding-Agenten lokal und auf dem VPS