Il progetto
- Categoria: Infrastruttura AI
- Ruolo: Progettazione e messa in servizio
- Periodo: Novembre 2026
- Stack: vLLM, Modal, Python, fp8, decodifica speculativa
Modelli open-weight in produzione con API compatibili OpenAI
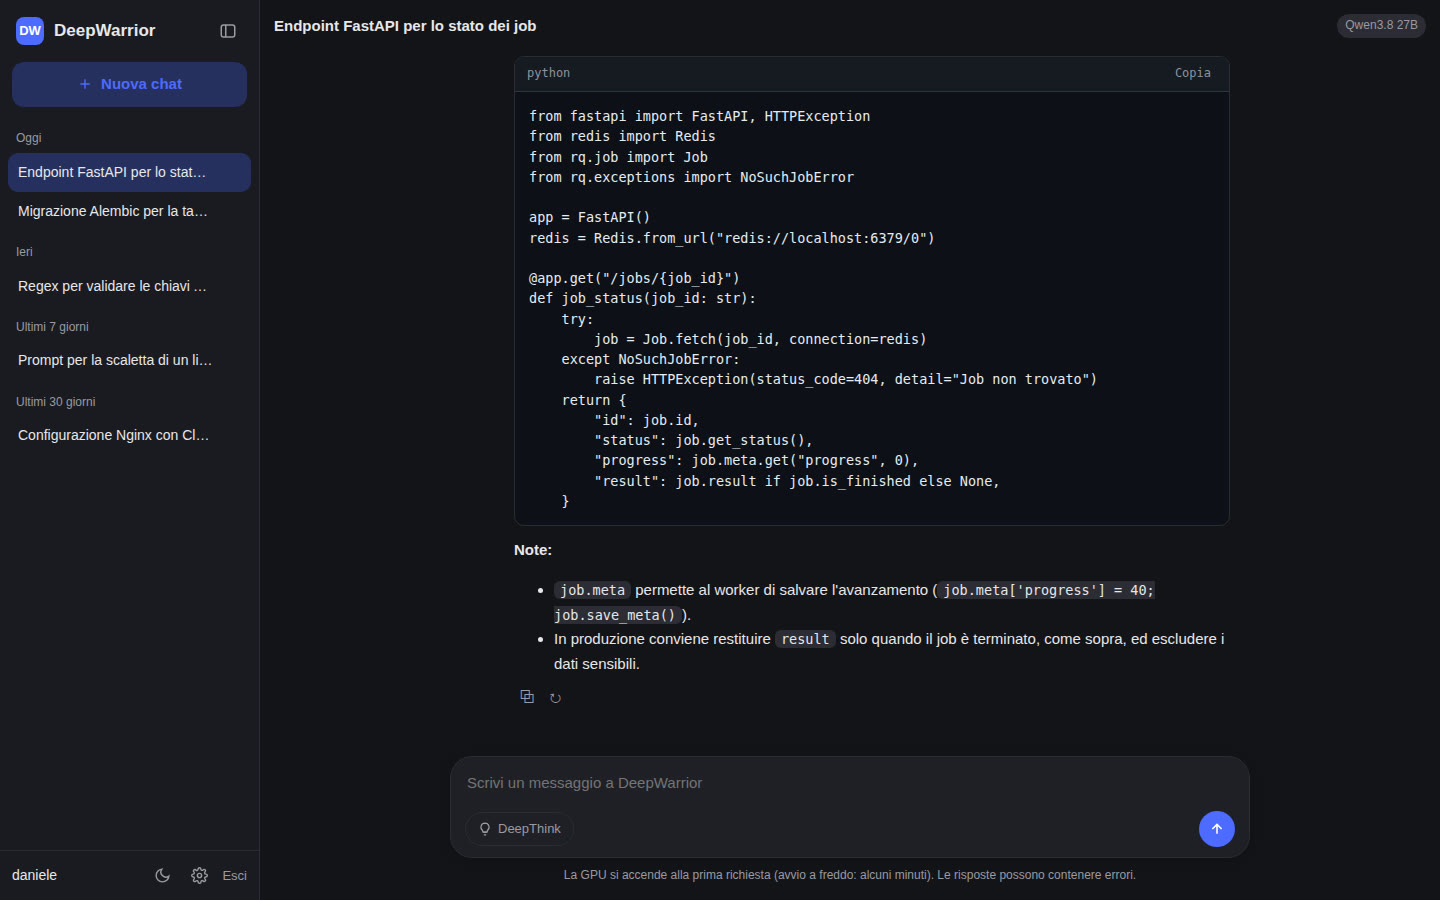
Ho messo in servizio su GPU cloud (Modal) due modelli linguistici open-weight, DeepSeek V4.1 Flash e Qwen3.8 27B, esposti con API compatibili OpenAI e un'interfaccia web di chat. L'obiettivo era avere modelli propri, economici e veloci, da usare con gli agenti di sviluppo.
Cosa ho realizzato
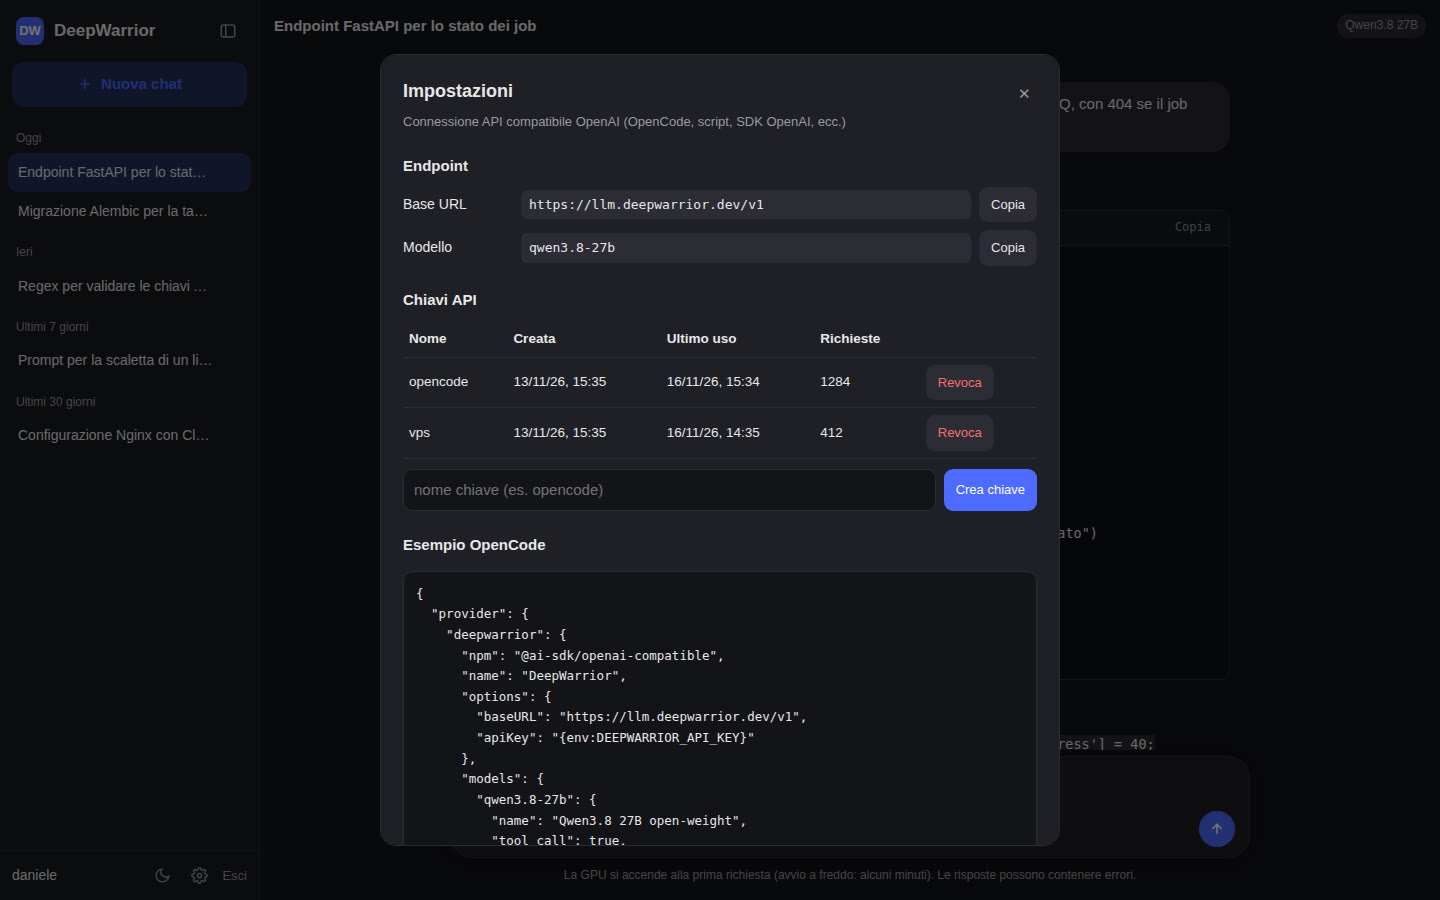
- Serving con vLLM, chiavi API revocabili, rate limit e interfaccia web di chat
- GPU che si spegne da sola quando non serve, per tenere bassi i costi
- Quantizzazione fp8 e decodifica speculativa (DFlash2): circa 300 token/s misurati su H200
- Modelli collegati agli agenti di coding in locale e sulla VPS