El proyecto
- Categoría: Infraestructura de IA
- Rol: Diseño y puesta en servicio
- Periodo: Noviembre 2026
- Stack: vLLM, Modal, Python, fp8, decodificación especulativa
Modelos open-weight en producción con API compatibles con OpenAI
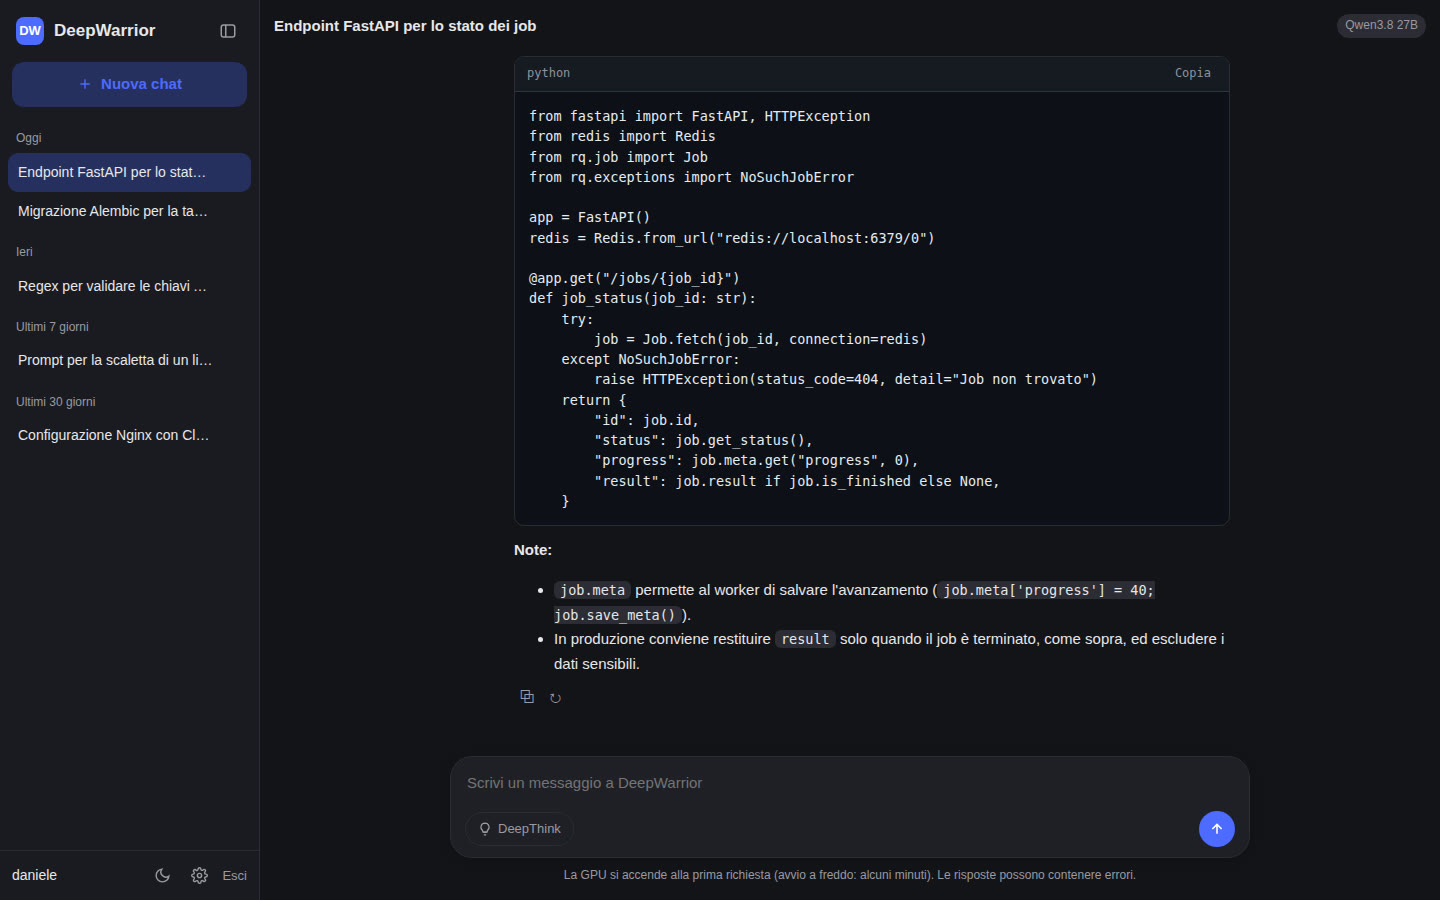
Puse en servicio en GPU cloud (Modal) dos modelos de lenguaje open-weight, DeepSeek V4.1 Flash y Qwen3.8 27B, expuestos con API compatibles con OpenAI y una interfaz web de chat. El objetivo era tener modelos propios, económicos y rápidos, para usarlos con los agentes de desarrollo.
Qué he realizado
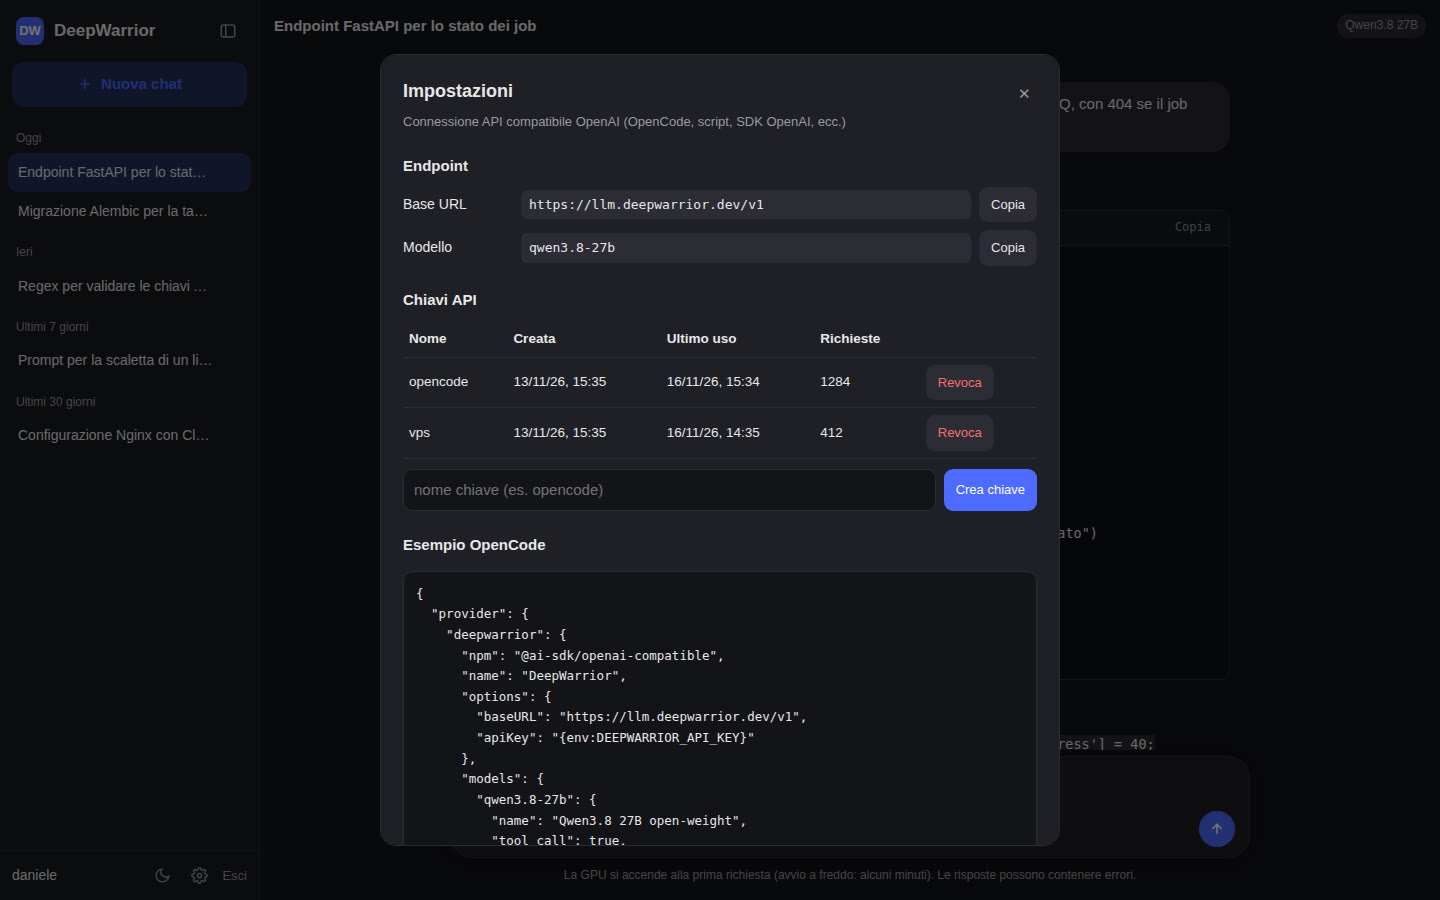
- Serving con vLLM, claves API revocables, rate limit e interfaz web de chat
- GPU que se apaga sola cuando no se necesita, para mantener bajos los costes
- Cuantización fp8 y decodificación especulativa (DFlash2): unos 300 token/s medidos en H200
- Modelos conectados a los agentes de programación en local y en el VPS